
Eine Empfehlung ist schnell ausgesprochen. Ob sie hilfreich ist, entscheidet sich auf der anderen Seite des Bildschirms. Für Unternehmen ist das eine ziemlich praktische Frage: Welche Inhalte passen zu dieser Person, zu ihrem Interesse und zum aktuellen Kontakt? Ein Empfehlungssystem soll darauf eine belastbarere Antwort geben als die Reihenfolge im Produktkatalog.
Personalisierung verbindet dafür drei Entscheidungen: Wer wird angesprochen, wann entsteht der Kontakt und welcher Inhalt wird angeboten? Aus Sicht der Customer Intelligence gehören diese Entscheidungen zusammen. Kundendaten werden nicht nur ausgewertet, sondern für einen konkreten Use Case genutzt. Entscheidend ist, ob daraus eine relevante nächste Handlung in der Kundenbeziehung wird.
Personalisierung braucht zuerst etwas Passendes zum Empfehlen
Der Blick auf Algorithmen ist verlockend. Vor der Modellauswahl steht jedoch eine einfachere Frage: Gibt es genügend Inhalte, die zu den unterschiedlichen Interessen der Kunden passen? Fehlt das passende Angebot, kann auch ein ausgefeiltes Modell keines herbeirechnen. Es sortiert dann bestenfalls genauer, was ohnehin nicht weiterhilft.
Die Grundlage bilden Informationen über Kunden, über Inhalte und über die Interaktionen zwischen beiden. Inhalte können Produkte, Dienstleistungen oder redaktionelle Beiträge sein. Der Zusammenhang ist wichtiger als das Format: Das System muss erkennen können, welche Person sich mit welchem Inhalt beschäftigt hat. Ohne diese Verbindung bleiben Kundenprofil und Inhaltsbestand zwei getrennte Sammlungen.
Ein Klick ist ein Signal, ein Kauf ein anderes
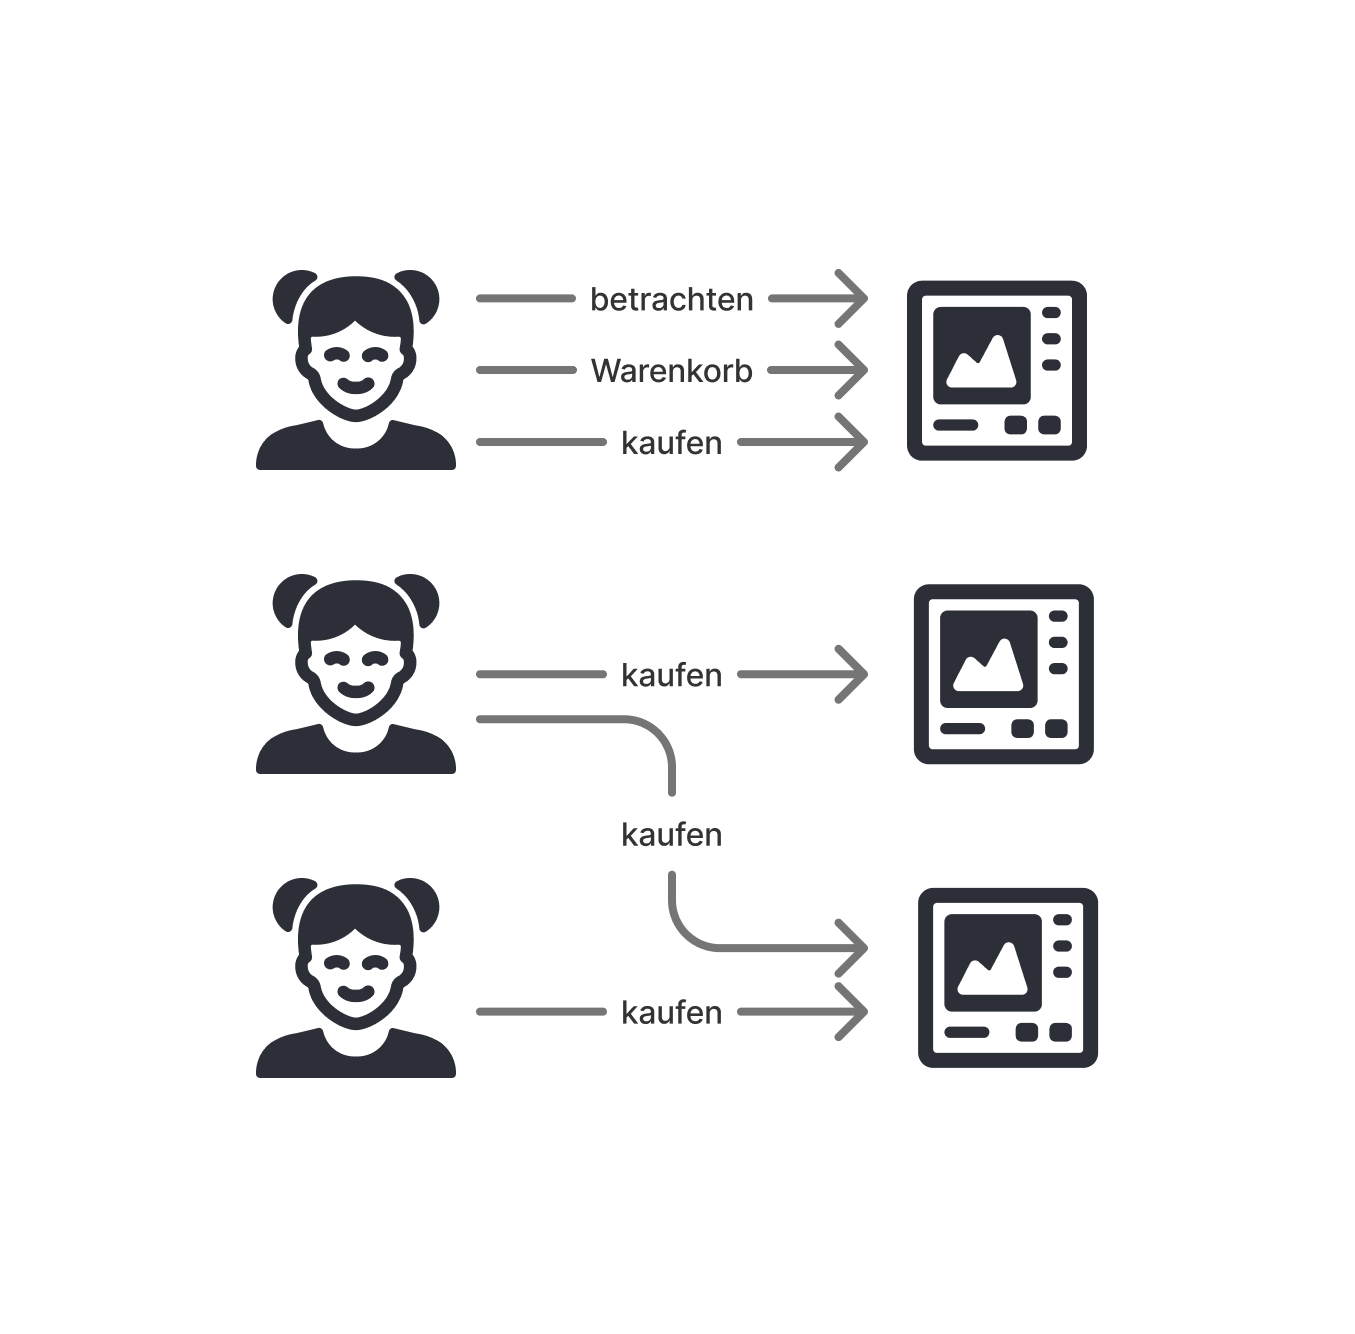
Verhaltensbasierte Empfehlungen lernen aus Interaktionen. Dazu gehören etwa das Betrachten einer Produktseite, das Hinzufügen eines Artikels zum Warenkorb oder ein Kauf. Solche Ereignisse haben unterschiedliche Aussagekraft und können im Modell unterschiedlich gewichtet werden. Sie sollten deshalb als unterscheidbare Vorgänge vorliegen.
Ein direkter Inhaltsbezug entsteht, wenn eine Interaktion auf das konkrete Angebot verweist, das später empfohlen werden soll. Daneben gibt es indirekte Beziehungen, etwa ein Interesse an einer Kategorie oder einer Produkteigenschaft. Hier braucht es eine zusätzliche Übersetzung: Aus der erkannten Vorliebe müssen passende einzelne Inhalte ausgewählt werden. Dafür können fachliche Regeln eingesetzt werden.
Welche Informationen für einen Use Case tatsächlich gebraucht werden, ist auch die Ausgangsfrage des SODA-Ansatzes zur Entwicklung einer passenden Datenbasis. Für Empfehlungen genügt es nicht, viele Kundendaten zu besitzen. Die Daten müssen etwas über die Verbindung zwischen Kunden und Inhalten aussagen.
Was Collaborative Filtering aus gemeinsamem Verhalten lernt
Ein verbreiteter Ansatz ist Collaborative Filtering. Dabei wird untersucht, welche Personen mit ähnlichen Inhalten interagieren. Aus diesen Gemeinsamkeiten lassen sich weitere Angebote ableiten, die für eine bestimmte Person interessant sein könnten. Ähnlichkeit meint hier ein ähnliches Verhalten gegenüber dem eigenen Angebot, keine umfassende Gleichheit der Menschen.
Für das Training werden historische Interaktionen gesammelt und in einem Modell verdichtet. Bei einer späteren Anfrage wird dieses gelernte Wissen mit den verfügbaren Informationen über die konkrete Person verbunden. So werden Inhalte ausgewählt, ohne jede mögliche Kombination aus Kundengruppe und Angebot von Hand zu pflegen.
Demgegenüber betrachten semantische Ansätze die Bedeutung von Inhalten und ihre Passung zu bekannten Interessen. Beide Perspektiven beantworten dieselbe Frage auf unterschiedlichen Wegen. Für die praktische Auswahl bleibt entscheidend, welche Daten verfügbar sind und wie gut sie das eigene Angebot abbilden.
Die Datenbasis ist mehr als die Vorbereitung für das Modell
Die Leistungsfähigkeit einer Empfehlung hängt nicht allein vom Algorithmus ab. Fehlerhafte oder unvollständige Interaktionen können auch ein anspruchsvolles Modell in die falsche Richtung führen. Die Qualität der Zuordnung, die Vollständigkeit der relevanten Ereignisse und ein nachvollziehbarer Inhaltsbezug sind deshalb Teil der fachlichen Lösung.
Eigene Interaktionsdaten haben dabei einen besonderen Wert: Sie beschreiben das Verhalten gegenüber dem eigenen Angebot. Allgemein verfügbare Verfahren können von vielen Unternehmen eingesetzt werden. Das darin gelernte Wissen über die eigenen Kunden entsteht dagegen aus dem jeweiligen Datenbestand. Hier liegt ein wichtiger Unterschied zwischen dem Zugang zu Technologie und ihrer tatsächlichen Nutzung für Customer Intelligence.
Segmente geben Orientierung, Empfehlungen schaffen Spielraum
Segmentierung und individuelle Empfehlungen schließen sich nicht aus. Größere, fachlich sinnvolle Zielgruppen können die grundsätzliche Ansprache steuern. Innerhalb dieser Gruppen lässt sich anschließend die Auswahl der Inhalte individualisieren. Damit muss nicht für jede denkbare Interessenlage ein weiteres Segment mit eigener Regelwelt entstehen.
Auch der Kanal verändert die Aufgabe. Bei einer E-Mail entscheidet das Unternehmen über den Zeitpunkt der Ansprache. Beim Besuch einer Website bringt die Person diesen Zeitpunkt selbst mit. Empfehlungen müssen dort zum aktuellen Kontakt passen. Wie aus Daten ein zusammenhängender Dialog entlang der Kundenreise wird, vertieft der Beitrag über Hyperpersonalisierung im B2B.
Ein berechneter Vorschlag muss im richtigen Kanal ankommen
Ein Modell allein personalisiert noch keine Kundenkommunikation. Die ausgewählten Inhalte müssen in Website, Shop oder E-Mail verfügbar werden. Ausgangspunkt ist das jeweilige Kundenprofil mit seinen aktuellen Interaktionen und dem relevanten Kontext. Die Verbindung zwischen Datenhaltung, Berechnung und Ausspielung gehört damit zum Aufbau des Empfehlungssystems.
Für die Umsetzung kommen fertige SaaS-Lösungen, Cloud-Dienste oder eine eigene Infrastruktur infrage. Sie unterscheiden sich vor allem beim Integrationsaufwand und bei den Möglichkeiten, Daten und fachliche Regeln einzubringen. Mehr Eigenentwicklung bietet Gestaltungsspielraum, verlangt aber auch entsprechendes Wissen und Ressourcen. Die passende Lösung ergibt sich aus der eigenen Datenwelt und den benötigten Anpassungen.
Der letzte Klick erzählt nicht die ganze Geschichte
Bei der Erfolgsmessung lohnt die Unterscheidung zwischen direkter und indirekter Konversion. Ein Kauf unmittelbar nach einer Empfehlung lässt sich anders zuordnen als ein späterer Abschluss. Zudem kann ein empfohlener Inhalt Interesse auslösen, obwohl anschließend ein anderes Produkt gekauft wird. Wer nur die unmittelbar angeklickte Empfehlung betrachtet, erfasst deshalb einen begrenzten Ausschnitt.
A/B-Tests ermöglichen den Vergleich unterschiedlicher Ansätze, etwa personalisierter und redaktionell ausgewählter Inhalte. Bewertet wird damit, wie sich die jeweilige Ausspielung auf das Verhalten der Gruppen auswirkt. Welche Kontakte eine Entscheidung beeinflussen und wie ihre Wirkung zugeordnet wird, ist auch Thema des Beitrags zur Attribution in der Marketingsteuerung.
Relevanz entsteht aus der Verbindung
Der praktische Einstieg beginnt beim eigenen Angebot und bei den Interaktionen damit. Welche Inhalte stehen zur Verfügung? Welche Signale können erfasst werden? Wie gelangen die daraus berechneten Empfehlungen zum nächsten Kontaktpunkt? Diese Fragen bilden eine zusammenhängende Aufgabe, keine getrennten Arbeitspakete für Marketing und Technik.
Generative KI erweitert die Möglichkeiten, semantische Beziehungen zwischen Inhalten zu nutzen. Das allgemeine Wissen eines Modells ersetzt jedoch nicht das Wissen über die eigenen Kunden. Auch hier bleibt der Bezug zur eigenen Datenbasis entscheidend. Gute Personalisierung entsteht, wenn Inhalte, verlässliche Kundendaten und die tatsächliche Verwendung im Kundenprozess zusammenfinden.
Eigenständige redaktionelle Aufbereitung auf Grundlage des Buchbeitrags „Personalisierung in der Praxis – Berechnung und Ausspielung von relevanten Inhalten“ von Dr. Philipp Sorg in Customer Intelligence (Springer Gabler, 2025). Zum Originalkapitel.